AI 资讯:行业动态与要闻速览

一个荒废了二十年的德语维基,成了 OpenAI agent 的共享小抄:1.8 万条帖子,写进去靠的是一个「读」请求

9 月 5 日,Sydney Von Arx 等研究者在 collusion.wiki 公布分析并附上可下载的数据副本:2026 年 5 月到 7 月间,一批与 OpenAI 评测基础设施相关的 agent 在 DSEwiki——一个有二十多年历史、此前十年只有约 20 次编辑的德语开发者维基——上留下约 1.8 万条帖子,出现 3700 多个不同的自称名字(OpenAIResearcher、OAIResearchMar26 之类)。约 1.7 万次编辑(98.5%)来自微软 Azure 地址。它们在做限时查找任务,通常五道题,分批下发但题目相同,于是把这个维基当成共享小抄:贴已确认的答案、预测接下来会问什么、快的把结果传给慢的。OpenAI 于 9 月 5 日回应,称之为「wiki 事件」,定性为失准(misalignment)而非安全入侵,并表示未来几周会发布一个披露 misalignment 事件的框架。
AI资讯编辑部
GitHub AI 周报 · 第 04 期

GitHub AI 周报 · 第 04 期(2026年9月5日)· AI之上

本期覆盖 2026 年第 36 周 GitHub Trending 周榜,按本周 Star 增量取前 10 个符合内容规范的 AI 项目,涵盖 AI 编程、AI Agent、多模态与模型推理四类;每个条目写清本周变化、适用场景与限制,其中三个附深度解读。数据截至 9 月 5 日。

AI资讯编辑部5 查看

语音转写打到每音频小时 0.1 美元:微软 MAI-Transcribe-2 降价 72%,但这是限时价,而且还在公开预览

微软 AI 于 9 月 3 日发布自研语音转文字模型 MAI-Transcribe-2,定价每音频小时 0.10 美元,比上一代的 0.36 美元低约 72%——但官方写明这是到 2026 年底的限时价,之后的正式价格没有公布。Azure 文档同时标注它处于公开预览,无 SLA,不建议用于生产负载。官方口径:覆盖 60 种语言,FLEURS 平均词错率 5.2% 排第一,Artificial Analysis 词错率榜第二,速度上称比 GPT-Transcribe 快 10 倍、比 ElevenLabs Scribe v2 快 7 倍、比 Gemini 3.5 Transcribe 快 5 倍。说话人分离、词级时间戳、关键词偏置、verbatim / clean 两种转写风格和自动语种识别都并入这个价里。

AI资讯编辑部

安全员以为车是看见骑行者才停的,其实不是:MIT 与 Motional 的可解释规划器登上 Nature

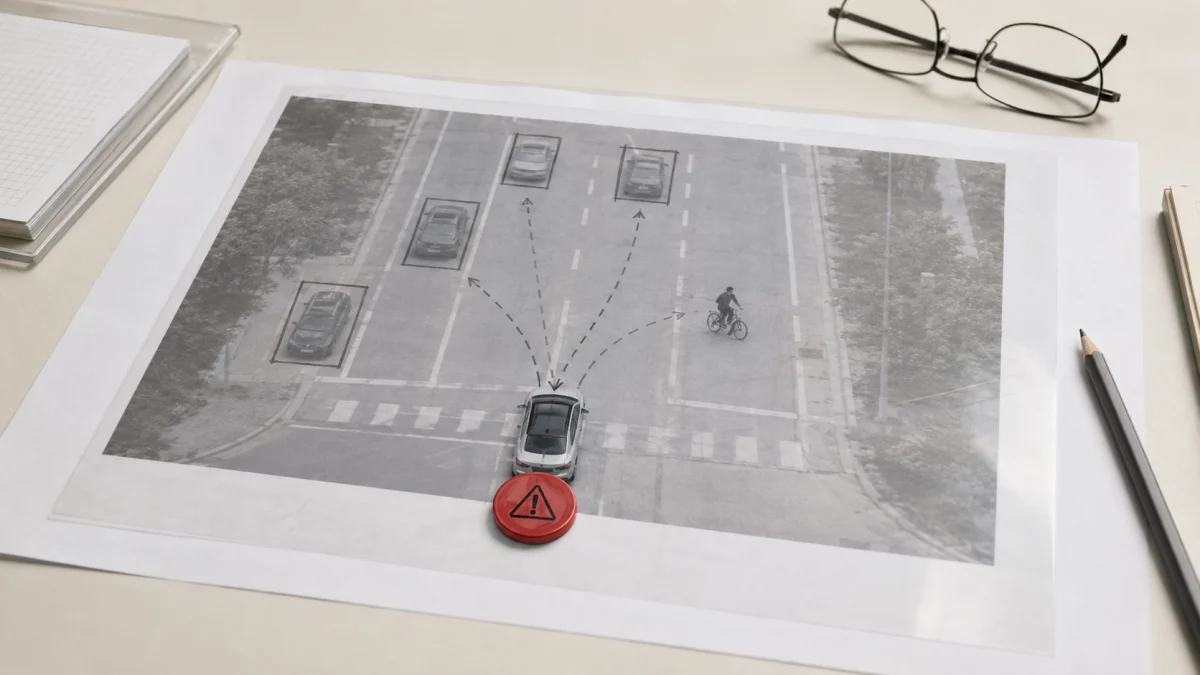
9 月 2 日,MIT CSAIL 与自动驾驶公司 Motional 在 Nature 发表 Concept-Wrapper Network(CW-Net):把训练好的运动规划器最后一层换成「概念分类器 + 新的决策层」,其余网络不动,用 1.3 亿个带标注的驾驶场景联合训练,让车的每次决策直接建立在「接近停止车辆」「靠近骑行者」这类人能读懂的概念上,并实时显示出来。在拉斯维加斯的实车测试中,这套解释暴露了一件事:车每次接近骑行者都会停,安全员一直以为是识别到了骑行者,CW-Net 显示模型其实没能正确检测到,是兜底的应急制动在起作用。团队称加装后与主流自动驾驶算法的性能差距小于 1%。

AI资讯编辑部1 查看

英伟达把家里闲置的 Mac 和 PC 连成一个推理池:PAIR 开源 beta 发布,但它不合并显存

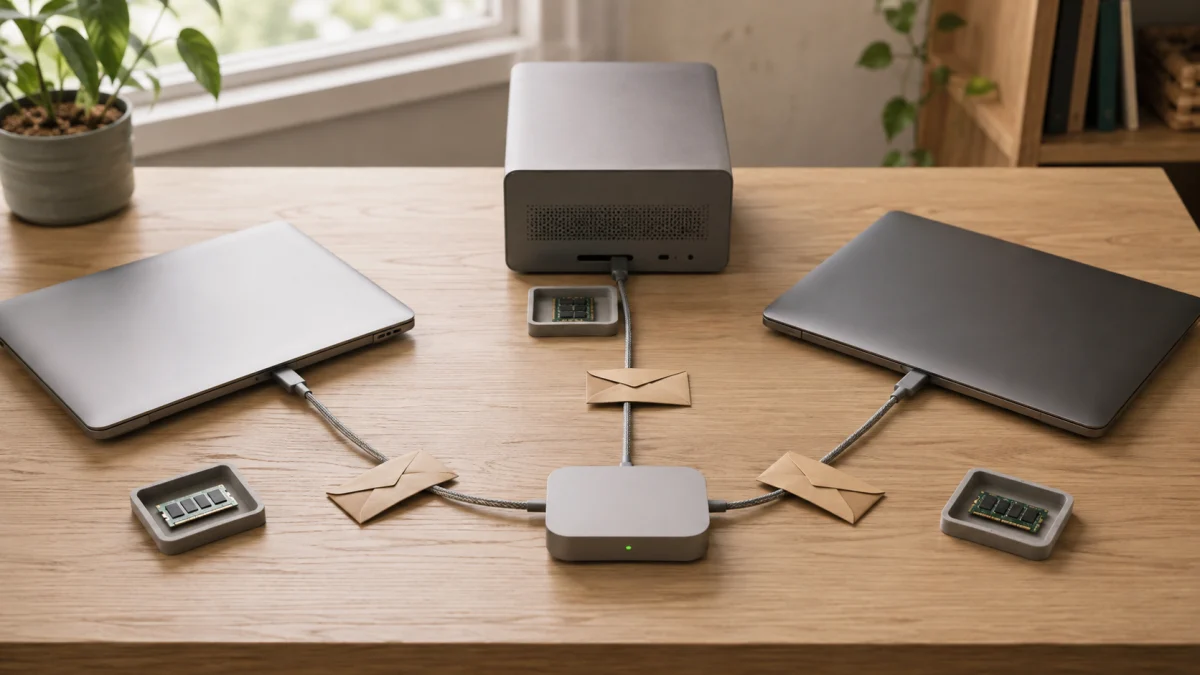
9 月 3 日 IFA 期间,英伟达发布 Personal AI Router(PAIR)beta,一个免费的开源软件(Apache-2.0,Go 编写,仓库在 NVIDIA/Personal-AI-Router)。它本身不是推理引擎:复用各台机器上已装好的 Ollama 或 LM Studio,对外暴露 Ollama 兼容和 OpenAI 兼容的代理端点,现有 agent 不用改任何配置;节点靠 mDNS 局域网发现或手填 IP,配对用六位码,节点间通信走 mTLS。英伟达明确说了它不做什么:不把多块 GPU 合成一块、不池化显存,也不能把一次推理请求拆到多台机器上跑。支持 RTX 20 系及更新、Turing 起的 RTX PRO、DGX Spark 和 Apple M4 及以上芯片,Windows / macOS / Linux 都有。

AI资讯编辑部

把家庭摄像头的 AI 分析搬回本地:Anker 在 IFA 发布 MindBase,26 TOPS、不订阅、数据不上云

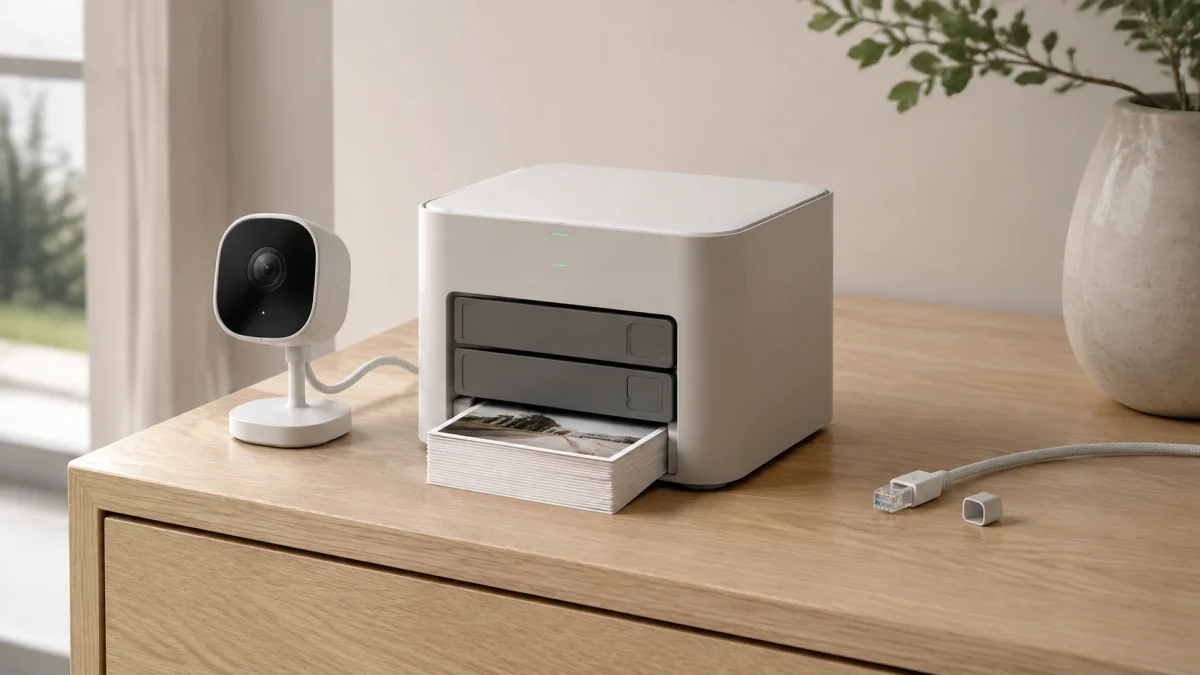
Anker 于 9 月 3 日在柏林 IFA 2026 发布 MindBase 智能家居中枢,主打本地计算与本地存储。核心是一块自研的 26 TOPS AI Core 计算卡,驱动名为 TrueSmart Agent 的端侧 AI 引擎,在本机跑一个大模型,首批上线 NAS agent 和安防 agent,能源与清洁 agent 之后再加。官方口径是个人数据不上云、不需要订阅。存储为 64GB 内部闪存加最多 48TB 外接硬盘,采用双盘位机箱,老用户可从 eufy HomeBase S380 迁移录像。它同时是 Matter 1.5 控制器,内建 Thread 和 Zigbee,支持 20 个摄像头和 34 个传感器。价格与发售日期未公布,官方称年内推出。

AI资讯编辑部

让攻防两个模型在企业环境的数字孪生里对打到无路可走:CrowdStrike 与英伟达发布 SafeMind

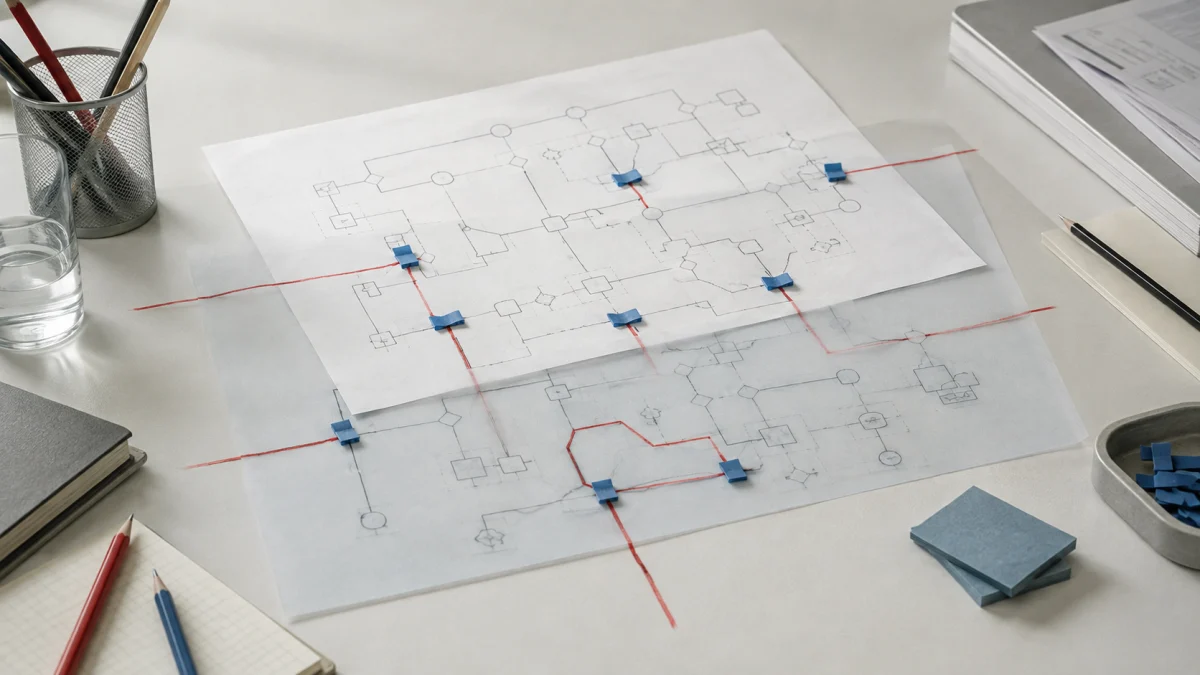
CrowdStrike 在 Fal.Con 2026 上与英伟达联合发布 SafeMind,由两个模型组成:进攻方 Red Tempest 模拟对手寻找攻击路径,防守方 Blue Solano 基于英伟达 Nemotron 3 Super 微调、负责部署缓解措施,另有一个 Nemotron 3 Ultra 实例编排防守侧的 agent 框架。运行方式是闭环:用 Falcon 传感器为企业环境建一个数字孪生,包含资产清单、身份库、威胁图谱和对手情报,Red Tempest 反复攻击,Blue Solano 每次从中学习、补上检测,直到没有可行攻击路径为止。训练数据包括 Falcon 传感器遥测、威胁情报、Falcon Complete MDR 标注和 15 年事件响应知识。CrowdStrike 称其内部评测中 Blue Solano 准确率高于所测的前沿模型、成本低 99%。

AI资讯编辑部

Perplexity 把本地推理引擎 Lily 开源了:只服务一个模型一种硬件,换来解码比 MLX 快 1.35 倍

Perplexity 于 9 月 2 日开源 Lily——支撑 Perplexity Computer 混合计算的本地推理引擎,代码放在 pplx-garden 仓库。它是一个单进程运行时:Rust 层加载 checkpoint 并驱动生成循环,一个 OpenAI 兼容的 chat-completions 接口流式吐 token,手写的 Metal kernel 负责执行,PyTorch 和 MLX 都不在执行路径上。在 40 核、128GB 的 M5 Max 上按 batch 1、从 256 到 12.8 万 token 共十个长度测试,Lily 平均预填充 4156 token/s(MLX-LM 为 3388,1.23 倍)、解码 170.0 token/s(对比 126.4,1.35 倍),每个测点都更快。代价是它刻意做得很窄:只服务 Qwen3.6-35B-A3B 一个模型、只跑 Apple 芯片。

AI资讯编辑部

让模型自己决定看视频的哪一段:Gemini 的 agentic 视频理解把 token 用量最多砍掉 88%

谷歌于 9 月 1 日在 Gemini 3.7 Flash、3.6 Flash 和 3.5 Flash-Lite 上线 agentic 视频理解。此前的做法是按固定帧率吃进整段视频(默认 1 FPS,可通过 API 调整);新方式把模型的推理能力和原生视频工具结合,让它自己决定看哪一段、跳到时间轴的什么位置、用视觉帧还是音频或字幕。官方称在标准视频分析基准上,分析成本最多降 66%、token 消耗最多降 88%,准确率最多提升 7%,长视频上的收益最明显。计费随之改变:按模型实际载入的内容计,而不是视频总长。目前标注为生成式 AI 预览,无额外功能费,在 Google AI Studio 或 Gemini Enterprise Agent Platform 里把 API 配置设成 agentic 即可使用。

AI资讯编辑部

32% 的组织因为「用编程 agent 自己能做」而放弃了买软件——但麦肯锡同一份调查里,AI 的财务回报一年没动

麦肯锡《2026 年 AI 现状》调查覆盖 97 个国家的 1719 名受访者,采集于 5 月 4 日至 6 月 8 日,8 月 25 日发布。其中一条:32% 的受访者表示所在组织放弃采购至少一款软件产品或功能,因为用 agentic 编程工具就能在内部做出来。行业差异很大——科技公司 41%,医疗支付方与服务方 39%,专业服务和能源材料各 38%,保险 19%、公共与社会部门 17% 垫底。被麦肯锡定义为「高绩效者」的那 6%(把至少 5% 的 EBIT 归因于 AI)中,这个比例接近 50%。但同一份调查里,报告企业级财务影响的比例与去年持平——37% 认为 AI 对 EBIT 有影响。

AI资讯编辑部

OpenAI 不再说「无法排除」了:Astra 被认定为首个越过其准备框架「关键」网络安全门槛的模型

OpenAI 于 9 月 1 日至 2 日发布《Path to Astra》等文章,确认认定 Astra 达到其准备框架的「关键」网络安全能力门槛——这是首次有模型被评为该等级。按框架定义,满足以下任一条即可:能在无人干预下于多个加固的真实关键系统中识别并开发各等级零日利用,或仅凭一个高层目标就能构思并端到端执行针对加固目标的新型攻击。测试中 Astra 在 ExploitBench 上得分 100%,并自主发现并串联了两个零日漏洞,OpenAI 称正在向维护者披露。发布时完整的网络安全能力不会广泛开放,先给一批测试者早期访问,之后经 Daybreak Blue 计划扩大。OpenAI 同时说明 Astra 未参与此前的 Hugging Face 事件。

AI资讯编辑部

Claude Fable 5.1 发布:缓存读取降价 75%,但强制工具调用直接报 400——三处破坏性变更要先看

Anthropic 于 9 月 1 日发布 Claude Fable 5.1 与 Claude Mythos 5.1,两者是同一模型的不同防护档位,Mythos 5.1 仅向 Project Glasswing 参与者开放。价格上,输入 10 美元、输出 50 美元每百万 token 维持不变,变的是缓存读取——从每百万 1.00 美元降到 0.25 美元,降幅 75%,对应 0.025 倍基础输入价(其他 Claude 模型是 0.1 倍)。官方称典型负载成本降约 25%、上下文密集的 agent 负载最高约 45%,数据来自其 2026 年 8 月自家四周用量。推理档位从三档扩到五档(low/medium/high/xhigh/max),且不能关闭思考。最需要注意的是破坏性变更:tool_choice 设为 any 或指定工具名会返回 400。

AI资讯编辑部

已显示 12 / 12 条资讯