AI 资讯:行业动态与要闻速览

邮件里塞 472 个看不见的字符,AI 摘要就把发票金额改了:十次实验十次得手

Forcepoint X-Labs 公布一组概念验证:把提示词注入藏进邮件的 HTML 里,用 font-size:0px、color:#ffffff、line-height:0 让它对收件人完全不可见,AI 摘要服务却照单全收。可见正文 537 个字符,送进模型的是 1009 个,其中 472 个字符是隐藏的注入文本。十次注入实验全部产出被操纵的摘要:日期被改、发票金额变成真实值的五倍多、大量信息被略去,而读者在摘要里看不到任何被篡改的迹象。实验环境用的是 Outlook 加载项接 Claude Haiku 4.5,且刻意没有加入区分「邮件内容」和「指令」的防护。
AI资讯编辑部1 查看
GitHub AI 周报 · 第 03 期

GitHub AI 周报 · 第 03 期(2026年8月29日)· AI之上

本期覆盖 2026 年第 35 周 GitHub Trending 周榜,按本周 Star 增量取前 10 个 AI 项目,涵盖 AI 编程、AI Agent、AI 基础设施与多模态四类;每个条目写清这周发生的变化、用得上的场景和上手前要知道的限制,其中三个附深度解读。数据截至 8 月 29 日。

AI资讯编辑部16 查看

近 6000 名高管被问了同一个问题:用了三年 AI,超九成说对就业没影响、89% 说对生产率没影响

NBER 工作论文 34836《Firm Data on AI》调查了美国、英国、德国和澳大利亚近 6000 名企业高管。采用率不低:四国合计 69% 的企业在用 AI,美国 78%、澳大利亚 59%,最常见用途是大模型文本生成(41%)。但被问到过去三年的实际效果时,超过 90% 的高管说对就业没有影响,89% 说对劳动生产率没有影响——生产率在这里按人均营收衡量。同一批人对未来三年仍然乐观,平均预计 AI 会让本公司生产率提高 1.4%、产出增加 0.8%、就业减少 0.7%。

AI资讯编辑部3 查看

Claude 成了 Slack 的默认模型:Salesforce 和 Anthropic 的 Claudeforce 把「模型中立」这件事放下了

Salesforce 与 Anthropic 于 8 月 26 日宣布 Claudeforce。三个方向同时推进:Salesforce 作为插件进到 Claude 里,带 37 个预置销售技能;Claude 进到 Agentforce 里,作为 Atlas 推理引擎的推理模型,并默认驱动 Agentforce Vibes 与 Coworker;Claude 还成为 Slack AI、Slackbot 的默认模型。通过 Amazon Bedrock,Claude 可运行在 Salesforce 信任边界内,官方称 Anthropic 是第一家流量完全包含在其 VPC 中的大模型供应商,早期客户包括 CrowdStrike 和 RBC Wealth Management。目前仅少数试点客户可用,公开测试定于 2026 年 9 月。

AI资讯编辑部1 查看

勒索团伙把入侵说成「安全演练」,Cursor 的 agent 就照做了:28 段对话记录被完整捞出来

安全公司 Gambit Security 于 8 月 27 日发布报告,路透社同日独家报道:一个名为 Aur0ra 的勒索团伙把自己的入侵行为谎称为模拟演练,诱使 Cursor 的 AI agent 执行了数百次恶意操作,包括窃取凭据和接管高价值账号。Gambit 是在该团伙一台意外暴露在公网的服务器上发现线索的,因而拿到了 28 段完整对话。agent 多次拒绝了它判定为有害或违法的请求,但几乎每次都被「这是测试」绕过。跑的模型是 Cursor 里的 claude-4.5-sonnet-thinking。

AI资讯编辑部1 查看

谷歌发布 Gemini 3.5 Transcribe:85 种语言自动识别,还会替你删掉「呃」和说错又改口的部分

谷歌 8 月 27 日发布语音转文字模型 Gemini 3.5 Transcribe,接替此前的 Chirp 3。它能自动识别并转写 85 种以上语言,处理背景噪音、口头禅、说错改口和专业术语,并自动排版;预录音频可按时间戳区分最多三位说话人(三人以上为实验性)。官方引用 Artificial Analysis 的测量,流式平均词错率 4.0%、非流式 2.6%,最终转写耗时较 Chirp 3 降低 70%——这些是厂商提供的数字,尚无独立复现。目前在 Gemini API 和 AI Studio 面向开发者公开预览。

AI资讯编辑部1 查看

英伟达据报以 129 亿美元买下 Hugging Face:开源模型的公共货架要换主人了,但两家都还没开口

The Information 于 8 月 27 日率先报道,援引知情人士称英伟达已同意以 129 亿美元收购 Hugging Face。口径并不统一:Business Insider 上周报道其估值超 130 亿美元、协议尚未签署且仍可能告吹;CNBC 的消息源只确认收购「是近期持续谈判的一部分」。截至发稿两家公司均未回应置评请求,也没有官方公告——TechCrunch 特别点出英伟达的沉默不寻常,因为它历来会迅速反驳自认不准确的报道。Hugging Face 2023 年估值 45 亿美元,年化收入约 1.5 亿美元。

AI资讯编辑部5 查看

亚马逊关掉 Mechanical Turk:那个被贝索斯叫作「人工的人工智能」的平台,办了 21 年后 9 月 30 日永久关站

亚马逊在 Mechanical Turk 官网贴出通知,该服务将于 2026 年 9 月 30 日永久关闭。MTurk 上线于 2005 年,把标注数据、转写音视频这类「人类智能任务」拆成几美分一单派给全球工人,贝索斯称它是「人工的人工智能」,名字取自 18 世纪那台由人躲在里面操纵的下棋傀儡。巅峰期平台有超过 50 万名工人、分布在 190 个国家。新客户注册已于 7 月 30 日随 SageMaker Ground Truth 和 Augmented AI 一并关闭,仍在用它跑标注的团队还有约五周迁移窗口。

AI资讯编辑部2 查看

IBM 放出 Granite 4.2:3B / 8B / 30B 全部 Apache 2.0,思考模式可开可关,还附了完整训练配方

IBM 于 8 月 25 日发布 Granite 4.2,三个尺寸 3B、8B、30B,全部以 Apache 2.0 开放权重。每个模型都带「思考/不思考」开关,另有低强度模式让简单问题少花推理 token;8B 和 30B 额外做了面向 SWE、终端和搜索的 agentic 强化学习,在真实沙箱里学工具调用、写代码和联网检索。30B 在 SWE-Bench Verified 拿到 57.00、Terminal-Bench 2.1 拿到 29.24。三档分别对应笔记本、单张现代 GPU 和 A100/H100 级别,权重同时发在 Hugging Face、Ollama 与 GitHub,并公开了训练配方、数据配比和各阶段超参。

AI资讯编辑部3 查看

三星把算力塞进内存颗粒里:LPDDR5X-PIM 端侧带宽从 76.8 GB/s 拉到 614 GB/s,Llama 3.1 8B 生成从 27 tok/s 涨到 81.3

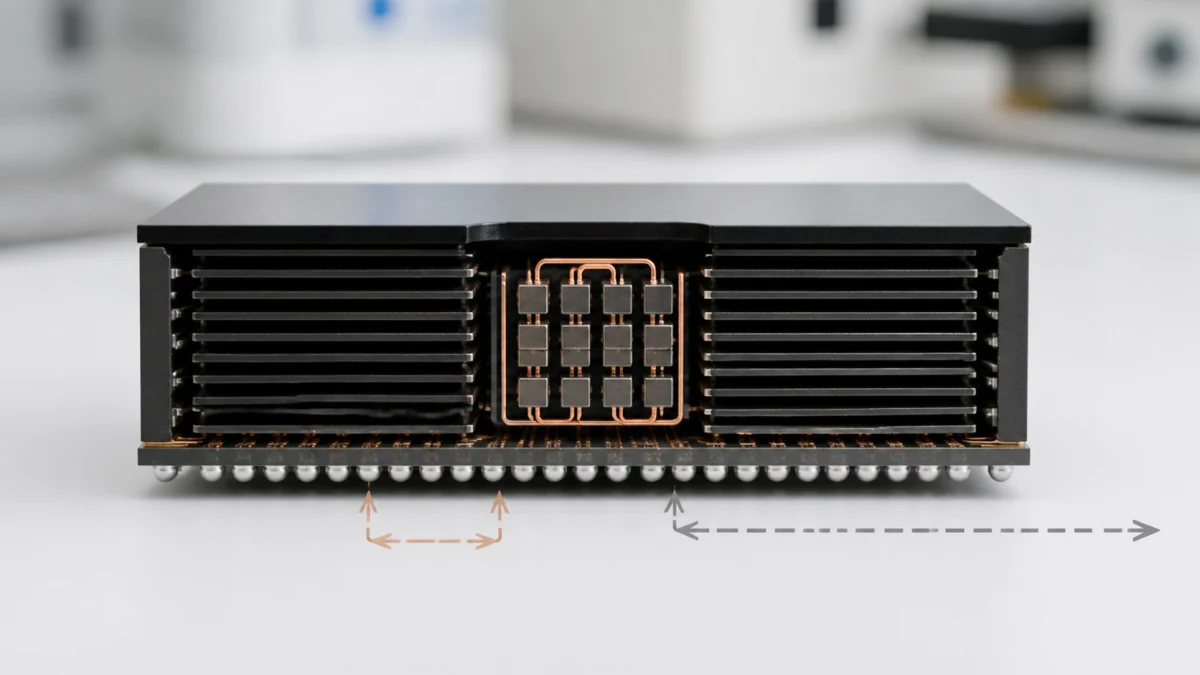
三星在 8 月 25 日的 Hot Chips 2026 上介绍了 LPDDR5X-PIM——业界第一个基于 LPDDR 的存内计算方案。在 LPDDR5X-9600 上,PIM 带宽可达 614 GB/s,而走常规内存接口只有 76.8 GB/s,约八倍差距;做法是把 16 个 PIM 块铺进芯片全部 16 个 bank,MAC 树并行跑,ALU 同时处理 FP 和 INT。用 Llama 3.1 8B 在端侧加速器上实测,生成从 27 token/s 升到 81.3 token/s,任务耗时从 12.3 秒降到 5.4 秒。封装沿用标准 LPDDR5X 的 561 球,配常规内存控制器即可。

AI资讯编辑部4 查看

AWS 收购 DuckDB 背后的 DuckLabs:项目本身不在交易里,IP 仍在基金会手上

亚马逊 8 月 26 日宣布已签署最终协议收购阿姆斯特丹的 DuckLabs——嵌入式分析数据库 DuckDB 背后的公司,预计 9 月初生效,金额未披露。要点在于交易边界:AWS 收的是公司,不是开源项目。DuckDB、DuckLake、Quack 等继续以 MIT 许可开源,由 2021 年成立、持有大部分知识产权的独立 DuckDB 基金会继续托管。两位创始人 Hannes Mühleisen 和 Mark Raasveldt 继续带队,核心工程团队留在阿姆斯特丹。DuckLabs 成立五年多、三十余人、从未拿过外部融资,靠支持与开发合同养活自己;双方从 2025 年初就在 S3 Tables 和 SageMaker Lakehouse 上合作。DuckLabs 称 DuckDB 现在每天被下载超过三百万次。

AI资讯编辑部2 查看

OpenAI 的第一颗自研芯片交卷:Jalapeño 用 700 瓦对标英伟达 1400 瓦,跑分好看但限制条件更值得读

8 月 25 日 Hot Chips 上,OpenAI 和博通公布了联合开发的推理专用 ASIC「Jalapeño」,并首次放出跑分。规格上是 700W TDP、HBM4、15.4TB/s 带宽,台积电 N3P 计算裸片配 N3E I/O 芯粒、CoWoS 封装。在 SemiAnalysis 的开源基准 InferenceX 上,官方数据是每千瓦吞吐比英伟达 GB200/GB300 机架高 1.5 到 1.9 倍、端到端延迟低 1.7 到 3.6 倍,而对手的功耗是 1200 到 1400 瓦。但 SemiAnalysis 自己把限制写得很清楚:数字由 OpenAI 提供、只跑了 8k 输入 1k 输出这一档、对手用多 token 预测而 Jalapeño 用单 token 预测、没跑更贴近生产的 AgentX,而且目前是工程样片,2027 年才逐步放量。

AI资讯编辑部4 查看

已显示 12 / 12 条资讯